Agent 开发学习路线:从基础到实践
Agent 这个词现在有点过量。每个产品都说自己是 agent,每篇文章都在讲 agent 会取代什么。但真正动手时你会发现,剥掉那些叙事,核心只有一句话:让模型能循环地调用工具,直到把事情做完。
围绕这句话,需要学的东西其实不多——五站。难的不是概念,而是每一站背后都有一堆工程细节:上下文什么时候会满、检索为什么不准、工具调用失败了怎么重试。
这篇把这条路线展开,但保持简短。如果你已经写过 Java 后端,这五站大概是一个月的事;如果还要补编程基础,先去看另一篇。
先说清楚
这是开发视角的路线,目标是「能自己写出一个 agent 应用」。如果你只是想用好现成的 agent 工具,不需要学这些。
五站,以及它们为什么是这个顺序
顺序不是随意排的。它对应一个 agent 从「能说话」到「能做事」的四次能力扩展,最后落到一个完整项目。
图 1 五站的依赖关系。顺序错了不会走不通,但会反复回来补课。
很多人从「抄一个 demo」开始,这没错——但要知道自己抄的是哪一层。如果不知道 chunk size 为什么设 512、不知道 top_k 调大调小分别影响什么,那这个 demo 只是能跑,不能改。
逐站展开
01
Token、开发框架、范式、结构化输出
这一站决定你后面所有代码的形状。Agent 不是「调用一次模型」,而是「让模型按某种格式表达意图,你来执行」。
**要搞懂的:**Token 是计费和上下文的单位(中文大约 1 字 ≈ 1–2 token,英文 1 词 ≈ 1.3);主流开发框架(LangGraph、LangChain、Spring AI)各自的抽象层次;agent 的几种范式(ReAct、Plan-and-Execute、Reflection 等);以及最重要的——结构化输出:怎么让模型稳定返回 JSON,而不是一段散文。
**过关标准:**能说清「为什么不能让模型直接返回自然语言然后你用正则提取」,以及 LangGraph 里「状态」这个概念解决了什么问题。
21:16:49
LangGraph 教程 · 智能体项目实战
尚硅谷 · 框架层抽象讲得比较系统
13:36
别再只会 ReAct 了:十几种 Agent 范式一次讲透
武哥聊编程 · 短,适合先建立范式地图
02
Embedding、切块、混合检索、Rerank 与 RAG 评测
这一站解决「模型不知道你的东西」。RAG 听起来简单——检索加生成——但真正难的是检索得准。
**要搞懂的完整链路:**文档解析 → 切块(chunk)→ Embedding → 向量入库 → 检索(向量 / 关键词 / 混合)→ 重排(Rerank)→ 拼进 prompt → 生成。
**过关标准:**能解释「为什么切块大小会影响答案质量」「为什么需要 Rerank,向量检索本身不够吗」「RAG 评测评的是什么指标」。
**最容易走错的地方:**把 RAG 当成一次性的向量查询。真实场景里,检索效果不好 80% 是切块或查询改写的问题,不是模型的问题。而评测这一步大多数人直接跳过,结果永远不知道自己是「改好了」还是「改坏了」。
04:24:06
《RAG》教程 · 大模型入门到进阶
吴恩达 · 从链路到评测,讲得清楚
03
Function Call、MCP 与 Skills
这一站是 agent 和聊天机器人的分界线:它能动手了。
**要搞懂的:**Function Call 的机制(你描述工具 schema,模型返回「我要调用哪个、参数是什么」,你执行后再把结果喂回去);MCP 是什么、为什么需要它(把「工具」从应用里解耦成协议);Skills 这种更上层的封装方式。
**过关标准:**能画出一个完整循环:用户提问 → 模型决定调工具 → 你执行 → 结果回填 → 模型再判断 → 直到不再调工具。以及能说清 MCP 和 Function Call 不是同一层的东西。
27:17
MCP 与 Function Calling 到底是什么关系
马克的技术工作坊 · 讲清了这两个最常被混淆的概念
04
上下文压缩、Memory 与 agent loop
这一站最容易被忽略,但它是决定 agent 能不能长时间干活的关键。上下文会满,这是所有 agent 应用的物理上限。
**要搞懂的:**agent loop 的完整形态(不是一次问答,而是一个带终止条件的循环);上下文占用率的监控;压缩策略(摘要、裁剪、分层记忆);长期 Memory 与短期上下文的区别。
**过关标准:**能回答「你的 agent 跑了 50 轮之后会发生什么」,并给出至少两种应对方案。
**一个直觉:**把上下文想成一张桌子。桌面就那么大,你要同时摊开任务说明、历史对话、检索结果、工具返回值。Memory 不是「记住更多」,而是「决定把什么从桌上收走」。
图 2 agent loop 的本质:一个带终止条件的循环。每一轮都把结果写回上下文,所以窗口一定会满。
14:52
关注你的 Agent 上下文占用率
一启-AI · 工程视角,讲为什么 agent 越用越蠢
16:30
10 分钟带你搞懂 Agent Memory
Agent开发实战 · 记忆架构与生产环境落地
05
项目:读两份源码,胜过看十篇教程
前四站学的都是零件。这一站看别人怎么把它们装成一台机器。
原笔记推荐了两个开源项目,恰好覆盖了上面两条主线——一个是 agent 本身,一个是 RAG。
项目一
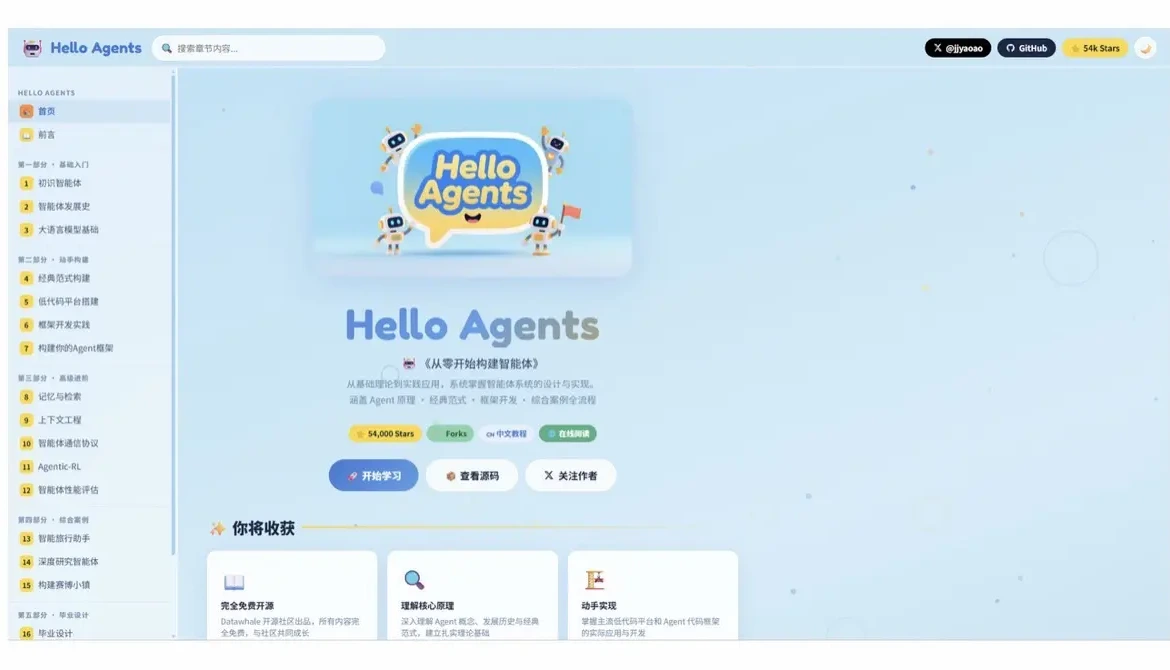
Hello Agents 一份从零构建智能体的中文开源教程,14k+ star。它的章节顺序几乎和上面的路线完全对应:基础入门(智能体是什么、大模型基础)→ 单卡构建(经典范式、低代码平台、框架实战)→ 高级进阶(记忆与检索、上下文工程、通信协议、Agentic RL、性能评估)→ 综合实战(旅行助手、深度研究、赛博小镇)→ 毕业设计。
最有价值的是第三部分:记忆、上下文工程、评估——正好是前一站讲的内容,而且有代码。
项目二
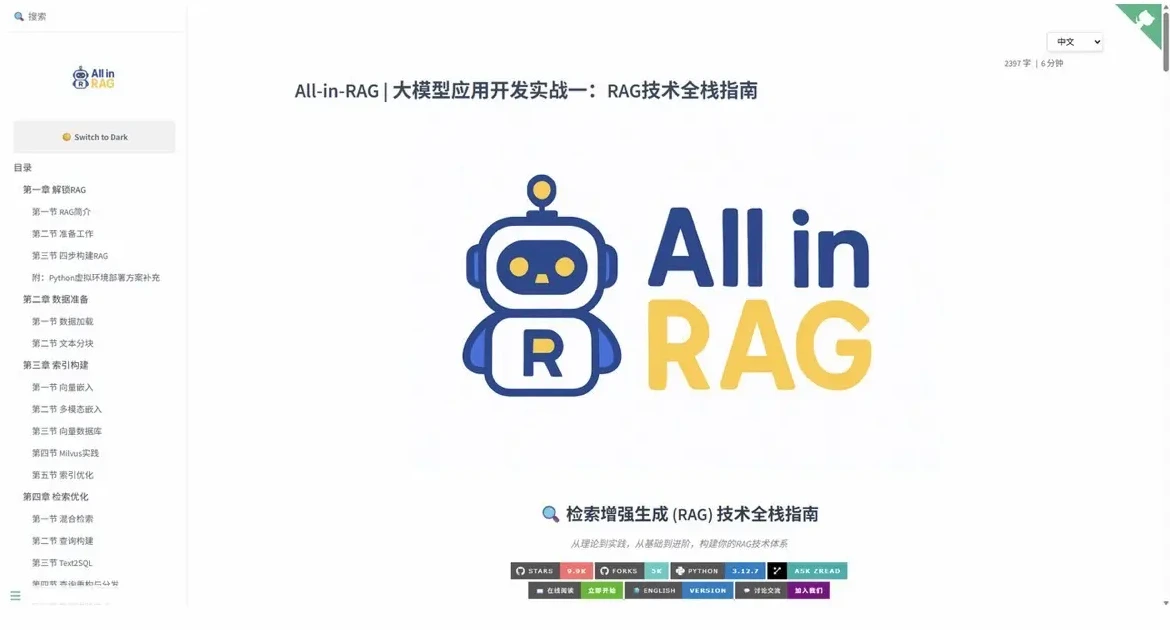
All in RAG RAG 技术全栈指南。目录本身就是一份学习地图:解锁 RAG(四步构建)→ 数据准备(加载、切块)→ 索引构建(向量嵌入、多模态、向量库、Milvus 实战、索引优化)→ 检索优化(混合检索、查询构建、评估)。
和第 2 站对照着看,会把「为什么要 Rerank」「索引优化到底优化什么」这些模糊的地方补上。
读源码的方式建议:不要从头读到尾。挑一个你最想做的场景(比如「给公司文档做问答」),照着项目里的实现自己重写一遍,卡在哪就回哪一站补。
几个判断
框架会换,机制不会
LangChain、LangGraph、Spring AI、各家 SDK,一年换一轮。但底层只有三件事:怎么让模型输出结构化意图、怎么执行工具、怎么管上下文。学的时候盯着这三件事,框架换了你也能迁移。
Agent 的难点不在智能,在失败处理
Demo 阶段一切都很顺:模型调工具、返回结果、生成答案。真实场景里你会遇到工具超时、返回格式不对、模型反复调同一个工具、循环停不下来。一个能用的 agent,一半代码在处理失败。
先做窄的,再做通用的
「一个什么都能干的 agent」是最容易失败的目标。反过来,一个只做「把 PDF 变成可问答」的 agent,一周就能做完,而且真的有人用。窄场景会逼你把 RAG 的每个环节都调对——这比做十个 demo 有用。
判断一个 agent 做得好不好,不看它能做多少事,看它失败的时候有多体面。
fin
尾声
这条路线只有五站,比 Java 后端那十一条短得多。但它的密度更高——因为每一站都没有「标准答案」,你得自己判断切块多大、top_k 取几、什么时候该压缩。
从这个角度看,学 agent 开发和学 Java 后端是两种不同的训练。后者更多是「把已知的东西做对」,前者更多是「在不确定里做决定」。这也是为什么同样一份路线,两个人走出来的水平差距会很大。
如果你刚开始,建议先做一件事:找一个你每天真的会用的场景,把它做成一个 agent。哪怕很粗糙。真实需求会替你回答那些教程回答不了的问题。
覆盖 Token 与范式 → RAG 全链路 → Function Call/MCP → 上下文与 Memory → 项目
建议周期 约 1 个月(有编程基础)
终点 Hello Agents · All in RAG